Ein Datenimport beginnt oft unspektakulär: Dateien einlesen, Tabellen anlegen, Daten schreiben. Solange Quelle und Ziel stabil bleiben, funktioniert das erstaunlich lange.
Interessanter wird es, wenn sich Anforderungen verändern. Neue Exportversionen bringen zusätzliche Spalten mit. Datentypen ändern sich. Eine weitere Datenbank soll unterstützt werden. Metadaten müssen anders interpretiert werden. Ein Import darf nicht nur technisch durchlaufen, sondern muss anschließend überprüfen können, ob die erwarteten Daten tatsächlich angekommen sind.
Aus einem Importskript wird damit ein ETL-System.
Das Ziel meines Java-Projekts ist deshalb nicht nur, Daten zu importieren. Der Importer soll metadatengetrieben, selbstvalidierend, transaktional abgesichert, streamingfähig und erweiterbar sein – und Änderungen möglichst dort isolieren, wo sie entstehen.
Die Pipeline
Der Import ist als kontrollierter Prozess aufgebaut:
Quelldaten
    ↓
Struktur erkennen
    ↓
Validierung der Rohdaten
    ↓
Metadaten einlesen
    ↓
Schema anreichern
    ↓
Reference-Schema prüfen
    ↓
SchemaDiff
    ↓
Zielschema erzeugen
    ↓
DatabaseScript ausführen
    │
    ├── Schema / DDL
    │
    ├── Streaming Load
    │       ↓
    │   Reconciliation pro Tabelle
    │
    └── weitere DB-Operationen
    ↓
Deployment-Validierung
    ↓
Fehlerprüfung
    ↓
Commit oder Rollback
Damit wird aus „Datei nach Datenbank kopieren“ ein Prozess mit definierten Vorbedingungen, Transformationen und Nachbedingungen.
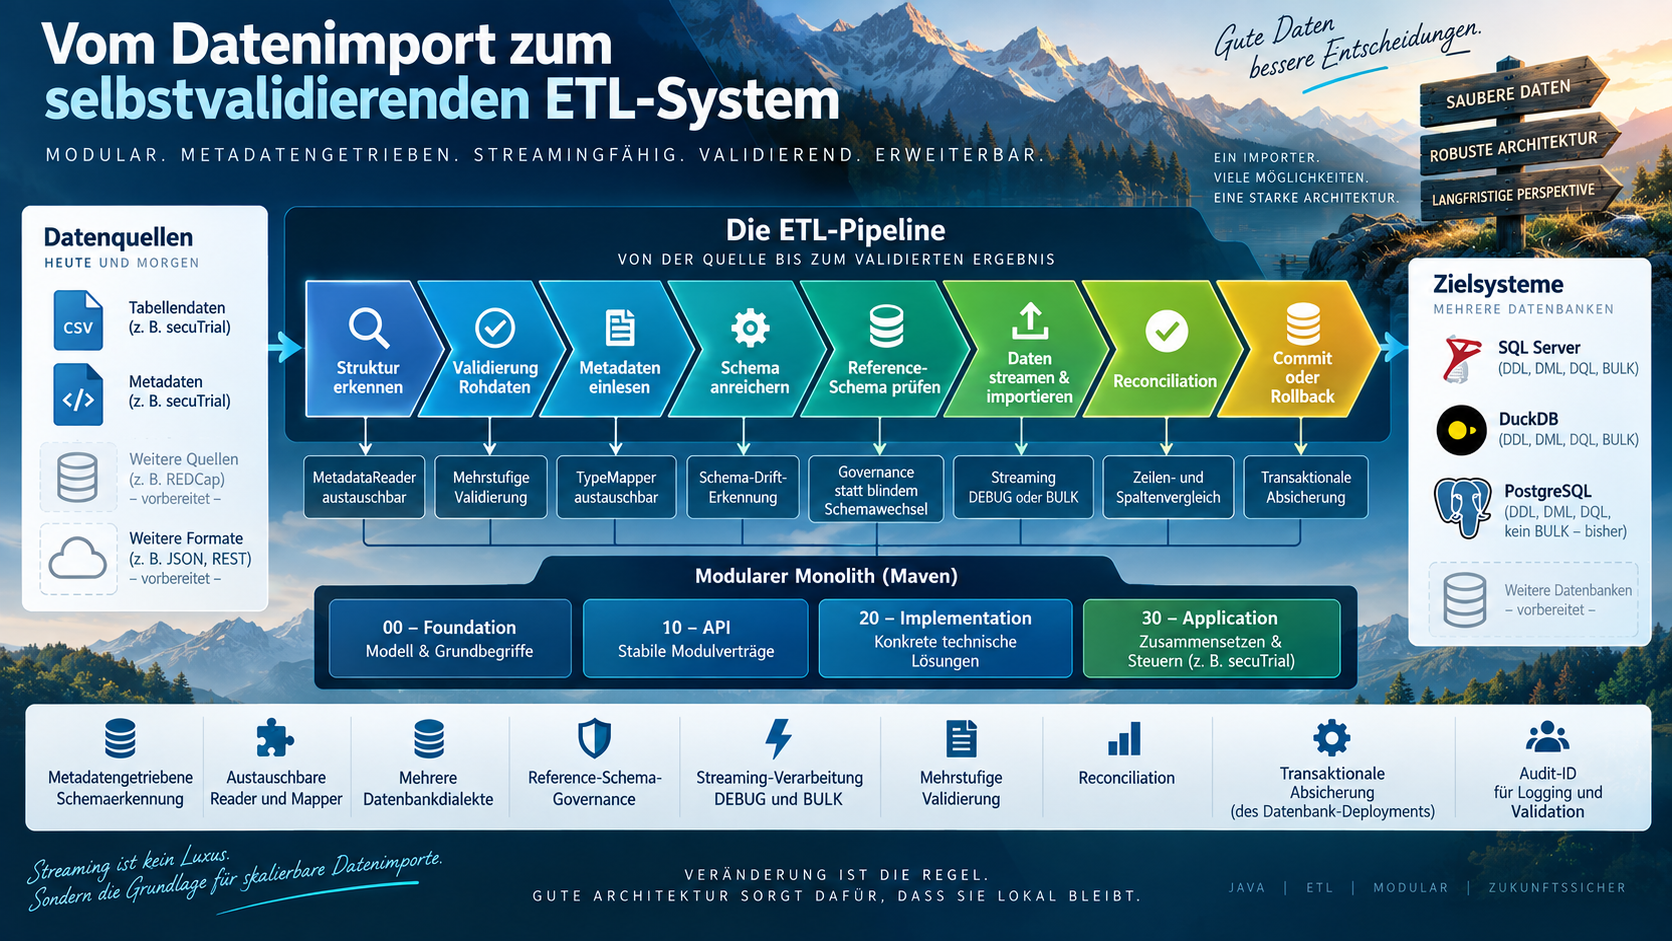
Ein modularer Monolith statt eines großen ETL-Core
Der Importer ist als Maven-Multi-Modul-Projekt aufgebaut. Die Module sind nach Stabilität und Verantwortung gruppiert:
etl-importer
│
├── 00-foundation
│   ├── etl-model
│   └── etl-exception
│
├── 10-api
│   ├── etl-connection-api
│   ├── etl-database-api
│   ├── etl-deployment-api
│   ├── etl-generator-api
│   ├── etl-io-api
│   ├── etl-mapper-api
│   └── etl-validator-api
│
├── 20-implementation
│   ├── etl-connection
│   ├── etl-database
│   ├── etl-deployment
│   ├── etl-generator
│   ├── etl-io
│   ├── etl-mapper
│   └── etl-validator
│
├── 25-infrastructure
│   ├── etl-config
│   └── etl-log
│
└── 30-application
    ├── etl-runner
    ├── etl-application
    ├── etl-bootstrap
    └── etl-importer-cli
Die Grundidee dahinter ist einfach:
              volatile Außenwelt
                     │
                     ▼
              30 Application
          Zusammensetzen & Steuern
                     │
                     ▼
           20 Implementation
       konkrete technische Lösungen
                     │
                     ▼
                 10 API
          stabile Modulverträge
                     │
                     ▼
             00 Foundation
         Modell & Grundbegriffe
                     │
                     ▼
                stabiler Kern
etl-model kennt weder SQL Server noch CSV noch secuTrial. Die äußeren Module dürfen
sich verändern, ohne den stabilen Kern ständig mitzuziehen.
Das Projekt bleibt trotzdem ein modularer Monolith: ein Repository, eine Anwendung und ein gemeinsamer Prozess – aber mit echten Maven-Grenzen innerhalb der Anwendung.
Austauschbare MetadataReader
Eine wichtige Eigenschaft der aktuellen Architektur ist die Entkopplung des Metadata-Readers.
Die konkrete Anwendung entscheidet beispielsweise:
DataTypeMapper metadataTypeMapper =
        new SecuTrialMetadataTypeMapper();

Reader<List<TableDefinition>> metadataReader =
        new SecuTrialMetadataReader(
                applicationContext,
                metadataTypeMapper
        );

ReaderFacade readerFacade =
        new StandardReaderFacade(
                applicationContext,
                csvReader,
                metadataReader
        );
Die darunterliegenden Komponenten arbeiten gegen den Reader-Vertrag und müssen secuTrial selbst nicht kennen.
                 Application
                      │
              wählt Quellsystem
                      │
                      ▼
      Reader<List<TableDefinition>>
                      ▲
                      │
          SecuTrialMetadataReader
Dadurch kann später eine andere MetadataReader-Implementierung eingebunden werden, ohne die Generator- oder Deploymentlogik neu zu entwerfen.
Eine mögliche zukünftige Erweiterung wäre beispielsweise ein REDCap-Reader. REDCap ist derzeit jedoch noch keine implementierte Datenquelle.
Austauschbare TypeMapper
Reader und Typinterpretation sind bewusst getrennt.
Für technische Spalten verwendet der Generator den Vertrag:
DataTypeMapperDie konkrete Application entscheidet derzeit beispielsweise über:
DataTypeMapper technicalTypeMapper =
        new SecutrialTechnicalTypeMapper();
Auch der MetadataReader erhält seinen TypeMapper von außen:
DataTypeMapper metadataTypeMapper =
        new SecuTrialMetadataTypeMapper();
Damit ergibt sich:
                 DataTypeMapper
                  ▲          ▲
                  │          │
       Metadata Mapper   Technical Mapper
                  │          │
                  └────┬─────┘
                       │
                       ▼
             Reader / Generator
Die konkrete Typinterpretation ist damit austauschbar, ohne sie tief in die Generatorlogik einzubauen.
Die eigentlichen Tabellendaten sind derzeit CSV-basiert
Während der MetadataReader bereits über ein Interface austauschbar ist, werden die eigentlichen
Tabellendaten aktuell über CsvReader verarbeitet.
Für die derzeitigen secuTrial-Exports ist das bewusst ausreichend.
Eine mögliche zukünftige Generalisierung wäre ein eigener neutraler Datenreader:
public interface TableDataReader {

    List<TableDefinition> readTables();

    Iterable<DataRow> readRows(
            TableDefinition table
    );
}
Damit könnten später beispielsweise weitere Datenquellen implementiert werden:
TableDataReader
      ▲
      │
      ├── CsvTableDataReader
      ├── JsonTableDataReader
      ├── DatabaseTableDataReader
      └── RestTableDataReader
Diese Abstraktion ist aktuell noch nicht Teil der Implementierung. Sie ist ein möglicher zukünftiger Erweiterungspunkt.
Streaming: große Datenmengen ohne großen Speicherbedarf
Eine der wichtigsten technischen Eigenschaften des Importers ist die Streaming-Verarbeitung der eigentlichen Tabellendaten. Große Exporttabellen müssen nicht vollständig in den Arbeitsspeicher geladen werden, bevor der Import beginnen kann.
Exportdatei
    ↓
Lazy / Streaming Reader
    ↓
Zeile für Zeile
    ↓
DEBUG / BULK LoadStrategy
    ↓
JDBC Batch / Bulk Loader
    ↓
Datenbank
Dadurch bleibt das Verarbeitungsmodell auch bei großen Tabellen grundsätzlich dasselbe. Der Importer muss nicht erst Millionen Datensätze als vollständige Java-Objektstruktur im Speicher materialisieren.
Besonders wichtig ist dabei die bewusste Trennung zwischen diskreten SQL-Operationen und Massendaten.
diskrete DB-Operationen             Massendaten

SqlCommand                           Streaming
    ↓                                    ↓
SqlExecutor                        LoadStrategy
    ↓                                    ↓
JDBC                             Batch / BULK
DDL, ALTER-Anweisungen und andere einzelne SQL-Kommandos können damit kontrolliert
über den zentralen SqlExecutor laufen, während große Datenströme nicht
künstlich in tausende oder Millionen SqlCommand-Objekte umgewandelt werden.
Das ist eine bewusste Architekturentscheidung: Streaming bleibt Streaming.
Streaming trotz transaktionaler Kontrolle
Streaming bedeutet dabei nicht, auf die Absicherung des Importlaufs zu verzichten. Der Datenbankpfad bleibt in eine JDBC-Transaktion eingebettet.
Streaming Import
       ↓
DEBUG / BULK
       ↓
Datenbank
       ↓
Reconciliation
       ↓
Deployment Validation
       ↓
   Ergebnis?
   ↙      ↘
Fehler     OK
  ↓        ↓
ROLLBACK  COMMIT
Damit verbindet der Importer zwei Anforderungen, die bei ETL-Systemen gleichermaßen wichtig sind: skalierbare Verarbeitung großer Datenmengen und eine kontrollierte Entscheidung über Commit oder Rollback.
Die Reconciliation vergleicht dabei unter anderem erwartete und tatsächlich importierte Zeilen- und Spaltenzahlen. Ein technisch durchgelaufener Streaming-Import muss deshalb nicht automatisch als erfolgreicher Import gelten.
Mehrere Datenbanken durch explizite SQL-Dialekte
Die zweite wichtige Variationsachse befindet sich auf der Zielseite. SQL Server, DuckDB und PostgreSQL sprechen zwar SQL, unterscheiden sich aber in zahlreichen Details.
Anstatt diese Unterschiede mit datenbankspezifischen
if-Abfragen über den gesamten Importer zu verteilen, werden sie über
einen DatabaseContext und spezialisierte Dialekte gekapselt.
DatabaseContext
      │
      ├── SqlDialect
      ├── DdlDialect
      ├── DmlDialect
      ├── DqlDialect
      ├── ConversionDialect
      └── BulkLoaderDialect
Die Verantwortlichkeiten bleiben dadurch getrennt.
DdlDialect
    ↓
Schema und DDL

DmlDialect
    ↓
Datenmanipulation

DqlDialect
    ↓
Abfragen

ConversionDialect
    ↓
datenbankspezifische Konvertierungen

BulkLoaderDialect
    ↓
datenbankspezifischer Massendatenimport
Aktuell existieren konkrete Datenbankimplementierungen für SQL Server, DuckDB und PostgreSQL. PostgreSQL besitzt im aktuellen Entwicklungsstand noch keine eigene BULK-Implementierung.
Der Generator muss die konkrete Datenbank nicht kennen
Für die Generatorlogik ist entscheidend, welche Fähigkeit sie benötigt, nicht welche konkrete Datenbank dahintersteht.
                    DdlDialect
                  ▲      ▲      ▲
                  │      │      │
            SQL Server DuckDB PostgreSQL
                  │      │      │
                  └──────┼──────┘
                         │
                         ▼
                    Generator
Dadurch muss die Generatorlogik nicht mit Konstruktionen wie dieser wachsen:
if (databaseType == SQL_SERVER) {
    ...
}
else if (databaseType == DUCKDB) {
    ...
}
else if (databaseType == POSTGRESQL) {
    ...
}
Datenbankspezifisches Verhalten bleibt stattdessen in der jeweiligen Datenbankimplementierung.
Source und Target sind weitgehend entkoppelt
Besonders interessant wird die Architektur durch die Kombination aus austauschbaren MetadataReadern und TypeMappern auf der Quellseite und austauschbaren Datenbankdialekten auf der Zielseite.
                 QUELLSYSTEM
                      │
              MetadataReader
                      │
                 TypeMapper
                      │
                      ▼
              neutrales ETL-Modell
                      │
          ┌───────────┼───────────┐
          ▼           ▼           ▼
      SQL Server    DuckDB    PostgreSQL
          │           │           │
          ▼           ▼           ▼
        Dialekte    Dialekte    Dialekte
Der MetadataReader muss nicht wissen, welche Datenbank später verwendet wird.
Ein PostgreSQL-Dialekt muss wiederum nicht wissen, aus welchem Quellsystem die Metadaten stammen.
Das neutrale Modell aus TableDefinition,
ColumnDefinition und TypeDefinition bildet die Grenze
zwischen diesen beiden Welten.
Streaming und Dialekte greifen ineinander
Besonders deutlich wird der Nutzen der Architektur beim eigentlichen Datenimport. Nicht nur die SQL-Syntax ist datenbankspezifisch – auch die optimale Methode, große Datenmengen zu laden, kann sich zwischen Datenbanken unterscheiden.
                    ETL-Modell
                        │
                        ▼
                 Streaming Data
                        │
                        ▼
                   LoadStrategy
                        │
              ┌─────────┼─────────┐
              ▼         ▼         ▼
         SQL Server   DuckDB   PostgreSQL
              │         │         │
              ▼         ▼         ▼
        DB-spezifische Fähigkeiten
Deshalb wird nicht versucht, allen Datenbanken künstlich dieselben Fähigkeiten
aufzuzwingen. Eine Datenbank kann beispielsweise einen eigenen
BulkLoaderDialect besitzen, während eine andere diese Capability
derzeit nicht implementiert.
Austauschbarkeit bedeutet nicht, dass alle Datenbanken identisch sind. Sie bedeutet, dass ihre Unterschiede an einer definierten Stelle gekapselt sind.
Schema Drift ist ein expliziter Bestandteil des Prozesses
Bei langfristig betriebenen Datenexporten verändert sich das Schema.
Neue Spalten erscheinen, bekannte Definitionen können sich verändern und neue Exportversionen können zusätzliche Strukturen enthalten.
Der Importer arbeitet deshalb mit einem erkannten Candidate Schema und einem persistierten Reference Schema.
aktueller Export
      ↓
Candidate Schema
      ↓
Reference Schema
      ↓
SchemaDiff
      ↓
bekannt / unbekannt
Beim ersten Lauf kann das erkannte Schema als Reference Schema gespeichert werden.
Bei späteren Läufen werden Abweichungen zwischen Candidate und Reference Schema erkannt.
Unbekannte Spalten werden nicht einfach stillschweigend übernommen.
Reference-Schema-Governance statt blindem Schemawechsel
Das aktuelle System führt keinen allgemeinen automatischen Schema-Migrationsworkflow über
ALTER TABLE durch.
Stattdessen wird geprüft, ob das erkannte Schema mit dem bekannten Reference Schema vereinbar ist.
aktueller Export
       ↓
Candidate Schema
       ↓
SchemaDiff
       ↓
unbekannte Spalten?
   ┌──────┴──────┐
   │             │
  JA            NEIN
   │             │
Abbruch      Schema erzeugen
Unbekannte Spalten werden dokumentiert und führen zu einem kontrollierten Fehler, statt unbemerkt in das Datenbankschema einzufließen.
Damit ist Schema Drift kontrollierbar, ohne so zu tun, als wäre bereits ein vollständiger automatischer Approval- oder Migration-Workflow implementiert.
Metadatengetriebene Typisierung
Die physische Datei allein enthält häufig nicht genügend Information, um die fachliche Bedeutung einer Spalte zu bestimmen.
Deshalb kombiniert der Importer technische Struktur und Source-Metadaten.
CSV-Struktur
      +
Source-Metadaten
      +
TypeMapper
      ↓
angereicherte TableDefinitions
Eine ColumnDefinition enthält dadurch neben dem Namen auch Typinformationen,
Metadata-Kennzeichnung und Informationen für mögliche Konvertierungen.
Für bestimmte Metadaten können zusätzliche technische Spalten erzeugt werden, beispielsweise:
original_column
original_column_conv
original_column_prec
Diese Logik liegt nicht im CSV-Reader, sondern in der Schema- und Generatorlogik.
Mehrstufige Validierung
Validation ist als eigener Bestandteil der ETL-Pipeline modelliert.
Dafür existieren getrennte Facades:
ConfigValidationFacade
RawTablesValidationFacade
EnrichedTablesValidationFacade
TransformationValidationFacade
DatabaseScriptValidationFacade
DeploymentValidationFacade
Damit können unterschiedliche Zustände des Imports separat geprüft werden.
Die konkrete Tiefe der einzelnen Validatoren ist derzeit unterschiedlich. Einige Validatoren sind bereits funktional, andere werden noch weiter ausgebaut.
Die Architektur für eine mehrstufige Selbstvalidierung ist damit vorhanden, ohne zu behaupten, dass bereits jede denkbare Prüfung vollständig implementiert ist.
Reconciliation: Ein erfolgreicher INSERT reicht nicht
Ein SQL-Befehl ohne Exception bedeutet noch lange nicht, dass der Import fachlich korrekt ist.
Deshalb wird während des Deployments eine Reconciliation der geladenen Tabellen durchgeführt.
Aktuell werden unter anderem erwartete und tatsächliche Zeilen- und Spaltenzahlen verglichen.
expected rows:      125481
database rows:      125481

expected columns:        84
database columns:        84

                 OK
Oder:
expected rows:      125481
database rows:      125479

               MISMATCH
Die Ergebnisse werden als ReconciliationResult modelliert.
Reconciliation ist dabei nicht nur Reporting. Fehler werden in den Lauf zurückgegeben und können verhindern, dass die Transaktion committed wird.
Import
   ↓
Reconciliation
   ↓
Fehler?
 ┌──────┴──────┐
 JA            NEIN
 ↓              ↓
ERROR          OK
 ↓              ↓
ROLLBACK       COMMIT
Transaktionale Absicherung des Datenbank-Deployments
Der DatabaseRunner kontrolliert die JDBC-Transaktion zentral.
Connection öffnen
      ↓
setAutoCommit(false)
      ↓
DatabaseScript erzeugen
      ↓
Script validieren
      ↓
Deployment ausführen
      │
      └── Reconciliation während des Loads
      ↓
Deployment validieren
      ↓
Fehler vorhanden?
   ┌──────┴──────┐
   │             │
  JA            NEIN
   │             │
ROLLBACK       COMMIT
Laufzeitfehler innerhalb dieses Datenbankpfades führen zu einem Rollback.
Ein SQLException-Fehler wird nach dem Rollback in eine EtlException
überführt.
Diese Transaktion umfasst die Datenbankoperationen. Dateisystem-Nebenwirkungen wie erzeugte Dateien oder gespeicherte Reference-Schema-Dateien werden durch einen JDBC-Rollback naturgemäß nicht zurückgenommen.
DEBUG- und BULK-Strategie
Für den Datenimport existieren unterschiedliche Ausführungswege.
DEBUG
  ↓
INSERT-basierter Import
  ↓
JDBC Batch


BULK
  ↓
DB-spezifischer Bulk-Import
DEBUG ist dabei kein Dry-Run. Auch im DEBUG-Modus können Datenbankänderungen committed werden.
BULK verwendet einen eigenen performanteren Ladeweg.
SqlQuery<T> macht Datenbankabfragen explizit
Auch Datenbankabfragen werden als eigene Query-Objekte modelliert.
SqlQuery<Long>kann beispielsweise eine Abfrage wie diese repräsentieren:
SELECT COUNT(*)
FROM dbo.patient
Das Ergebnis wird über einen ResultSetMapper<T> in einen Java-Wert überführt.
SqlQuery<T>
      ↓
SqlExecutor
      ↓
ResultSet
      ↓
ResultSetMapper<T>
      ↓
T
Damit existiert neben dem Command-Pfad auch ein klar definierter Query-Pfad.
Audit-ID für einen Importlauf
Ein Importlauf besitzt eine eigene Audit-ID:
UUID auditId = UUID.randomUUID();
Diese Audit-ID ist Bestandteil des ApplicationContext und wird unter anderem
für Logging und Validation verwendet.
                 auditId
                    │
            ApplicationContext
                    │
            ┌───────┴────────┐
            ▼                ▼
        LogReport      ValidationReport
Die Reconciliation-Ergebnisse können über den Lauf und das Logging dem jeweiligen Importlauf zugeordnet werden, besitzen derzeit aber nicht selbst eine eigene Audit-ID-Eigenschaft.
Persistente Importstatistik ist ein nächster Ausbauschritt
Eine persistente Importstatistik in der Zieldatenbank ist als weiterer Ausbauschritt vorgesehen, aber im aktuellen Stand noch nicht vollständig implementiert.
Dort könnten später beispielsweise Informationen gespeichert werden wie:
audit_id
started_at
finished_at
database_type
execution_mode
status
rows_expected
rows_imported
validation_errors
committed
Damit könnte ein Importlauf langfristig nicht nur über Logdateien, sondern zusätzlich strukturiert in der Datenbank nachvollzogen werden.
Fail Fast statt später NullPointerException
Ein wichtiger Teil der Härtung besteht darin, ungültige Zustände möglichst früh zu erkennen.
Beispielsweise wird bei Metadata Columns geprüft, ob ein erwarteter Typ tatsächlich vorhanden ist, bevor die Spalte weiterverarbeitet wird.
MetadataReader
      ↓
getUniqueMetadataColumns()
      ↓
Type vorhanden?
   ┌──────┴──────┐
   │             │
  NEIN           JA
   │             │
EtlException   weiter
Dadurch entsteht ein Fehler mit fachlichem Kontext wie Tabelle und Spalte, statt erst später in einer Collection oder einem Comparator als schwer verständliche NullPointerException aufzutreten.
Testbarkeit durch injizierte Abhängigkeiten
MetadataReader und TypeMapper werden an zentralen Stellen von außen injiziert.
Dadurch können Generator- und Enrichment-Komponenten grundsätzlich auch mit alternativen Testimplementierungen betrieben werden.
Reader<List<TableDefinition>> reader =
        new FakeMetadataReader();

DataTypeMapper mapper =
        new FakeTypeMapper();
So lassen sich Schema- und Mappinglogik isolierter testen.
Ein umfassender automatisierter Testbestand ist derzeit allerdings noch ein wichtiger weiterer Ausbauschritt.
Kompatibilität über synthetische Exportversionen
Für einen langlebigen Importer bietet sich zusätzlich eine Kompatibilitätsmatrix mit synthetischen Exporten unterschiedlicher Quellversionen an.
                    SQL Server   DuckDB   PostgreSQL

Export Version A         ✓          ✓          ✓
Export Version B         ✓          ✓          ✓
Export Version C         ✓          ✓          ✓
Eine solche Matrix ist ein sinnvolles zukünftiges Testziel und kein bereits vollständig implementierter Bestandteil des aktuellen Projekts.
Erweiterbarkeit bedeutet lokale Änderungen
Der eigentliche Architekturtest lautet:
Wie viele bestehende Komponenten muss ich ändern, wenn etwas Neues hinzukommt?
Eine weitere Datenbank sollte hauptsächlich neue Implementierungen in diesen Bereichen benötigen:
DatabaseContext
Dialekte
ggf. BulkLoaderDialect
Ein weiteres Quellsystem betrifft vor allem:
MetadataReader
TypeMapper
ggf. später TableDataReader
Eine weitere Qualitätsprüfung betrifft:
ValidatorEine weitere Deployment-Variante betrifft:
DeploymentStrategyWenn dafür der stabile Kern nicht angepasst werden muss, erfüllt die Modulgrenze ihren Zweck.
Das Zusammenspiel der Features
Die eigentliche Stärke liegt weniger in einem einzelnen Feature als in deren Kombination:
              MetadataReader
                    ↓
                TypeMapper
                    ↓
             neutrales Modell
                    ↓
          Schema-Drift-Prüfung
                    ↓
               Validierung
                    ↓
          Datenbank-Dialekte
                    ↓
           Streaming-Import
                    ↓
       DEBUG / BULK LoadStrategy
                    ↓
            Reconciliation
                    ↓
          Deployment-Validation
                    ↓
           COMMIT / ROLLBACK
Der Importer kann damit Änderungen an der Quelle, unterschiedliche Zielsysteme und große Datenmengen behandeln, ohne diese Anforderungen in einer einzigen zentralen Importklasse miteinander zu vermischen.
MetadataReader und TypeMapper kapseln die Interpretation der Quelle. Dialekte kapseln die Datenbank. Streaming skaliert den Datentransport. Reconciliation und Transaktionen sichern das Ergebnis ab.
Architektur verhindert Veränderung nicht – sie begrenzt ihre Auswirkungen
Das ist die zentrale Idee hinter dem Projekt.
Ein ETL-System kann nicht verhindern, dass:
- sich Exportformate ändern,
- neue Spalten auftauchen,
- Datenbanken unterschiedliche Dialekte besitzen,
- neue Validierungsregeln notwendig werden,
- weitere Quellsysteme hinzukommen.
Eine gute Architektur versucht deshalb nicht, Veränderung zu verhindern.
Sie sorgt dafür, dass eine Änderung dort bleibt, wo sie fachlich hingehört:
Änderung am Quellsystem
        ↓
Reader / Mapper

Änderung der Datenbank
        ↓
DatabaseContext / Dialect

neue Qualitätsregel
        ↓
Validator

neue Deployment-Technik
        ↓
DeploymentStrategy

Änderung grundlegender Datenstrukturen
        ↓
Foundation
Genau dadurch wird aus einem wachsenden Importskript ein wartbares System.
Langzeitwartbarkeit durch geringe Plattformabhängigkeit
Ein weiteres Ziel des Projekts ist ein möglichst langer und kontrollierbarer technischer Lebenszyklus.
Der Importer ist deshalb bewusst nicht an eine große ETL-Plattform gebunden. Seine technische Basis besteht im Wesentlichen aus Java, Maven, JDBC, Datenbanktreibern und wenigen zusätzlichen Bibliotheken.
ETL-Logik
    ↓
eigene Module
    ↓
Java + JDBC
    ↓
Datenbank
Dadurch bleibt die Zahl der technologischen Abhängigkeiten überschaubar. Änderungen an einer externen ETL-Plattform, proprietären Projektformaten, Plugin-Systemen oder grafischen Jobdefinitionen beeinflussen den Importer nicht.
Bei einem späteren Java-LTS-Wechsel müssen damit vor allem Compiler, verwendete Bibliotheken und JDBC-Treiber geprüft werden. Die eigentliche ETL-Architektur bleibt davon weitgehend unabhängig.
Für einen Importer, der über viele Jahre betrieben werden soll, ist diese geringe Plattformabhängigkeit eine bewusste Architekturentscheidung.
Fazit
Der aktuelle Stand des Projekts kombiniert bereits eine ganze Reihe technisch real implementierter Eigenschaften:
metadatengetriebene Schemaerkennung, austauschbare MetadataReader und TypeMapper, mehrere Datenbankdialekte, Reference-Schema-basierte Schema-Drift-Erkennung, Streaming-Verarbeitung, DEBUG- und BULK-Load-Strategien, zentrale SQL-Ausführung für diskrete Commands und Queries, transaktionale Absicherung des Datenbank-Deployments, mehrstufige Validierung, Reconciliation sowie eine Audit-ID für Logging und Validation.
Daneben sind weitere Ausbaupunkte sinnvoll anschließbar,
etwa ein neutraler TableDataReader, persistente Importstatistik,
weitere Quellsysteme und eine umfassende Kompatibilitäts-Testmatrix.
Entscheidend ist dabei weniger die Anzahl einzelner Features als ihr Zusammenspiel:
QUELLE
  │
  ▼
MetadataReader
  │
  ▼
TypeMapper
  │
  ▼
neutrales ETL-Modell
  │
  ├──────────────► Validation
  │
  ▼
Streaming
  │
  ▼
LoadStrategy
  │
  ▼
DatabaseContext / Dialekte
  │
  ▼
ZIELDATENBANK
  │
  ▼
Reconciliation
  │
  ▼
Deployment Validation
  │
  ▼
Transaction
  │
  ▼
COMMIT / ROLLBACK
Der stabile Kern beschreibt die Daten und grundlegenden Begriffe. Die äußeren Module entscheiden, woher Daten kommen, wie sie interpretiert, validiert und in welches Zielsystem sie geschrieben werden.
Gute ETL-Architektur verhindert Änderungen nicht. Sie sorgt dafür, dass Änderungen lokal bleiben.
Und genau an diesem Punkt wird aus einem Importer ein System.